> For the complete documentation index, see [llms.txt](https://help.impact.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://help.impact.com/brand/ja/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-channels/channel-setup-strategy.md).
# チャネル設定戦略
{% hint style="warning" %}
**重要**:この記事に進む前に、以下のリソースに目を通してください:
* [Optimizeスタートアップガイド](/brand/ja/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-startup-guide.md)
* [ルールターゲットとは何ですか?](/brand/ja/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/set-up-rules-to-identify-channel-traffic.md)
* [クレジットグループとは何ですか?](/brand/ja/what-would-you-like-to-learn-about/platform-features/actions-and-payouts/credit-groups-explained.md)
{% endhint %}
この記事では、OptimizeのRules To Identify(RTI)の機能と使い方を解説します。新しいチャネルに対してRules To Identify(RTI)を設定する戦略の立て方や、プログラム内の既存チャネルを変更する方法を学べます。
すべての状況に当てはまる万能の解決策はありません。ただし、独自の状況に最も適した解決策にたどり着くことはできるはずです。特定のRTIの設定に反対する論拠は常にありえますが、 **RTIの目的は、あらゆる状況で機能することではありません**. **RTIは、あなたの特定の状況に最も適するように調整されるべきものです**.
このドキュメントでは、プログラムに最適なRules To Identifyを設計するために必要な基礎知識と機能的知識を深めていきます。
{% hint style="info" %}
**チャネル設定は焦点を絞る**:Optimizeはチャネル単位のインサイトを明らかにすることを目的としていることを忘れないでください。RTIを作成する際は、特定のチャネルから来るトラフィックをどのように識別するかを考慮する必要があります。この点を念頭に置くことで、RTIをシンプルかつ焦点が定まり、効果的なものに保ちやすくなります。
{% endhint %}
**ちょっとした注意**
* ルールターゲットとは、ルールロジックを適用し、ルール値を見つける「場所」です。
* ルールロジックとは、ルールがトラフィックを識別しようとする「方法」です。
* ルール値は、ルールに活用のため入力する値です。
#### 精度と信頼性
RTIを設計する際に念頭に置くべき重要な概念は、精度と信頼性です。ルール内のルールターゲットとルールロジックの選択肢は、たとえあるシナリオで複数の組み合わせが機能するとしても、互換的なものとして見なすべきではありません。以下のセクションでその例を示します。
ルールターゲットを選ぶ
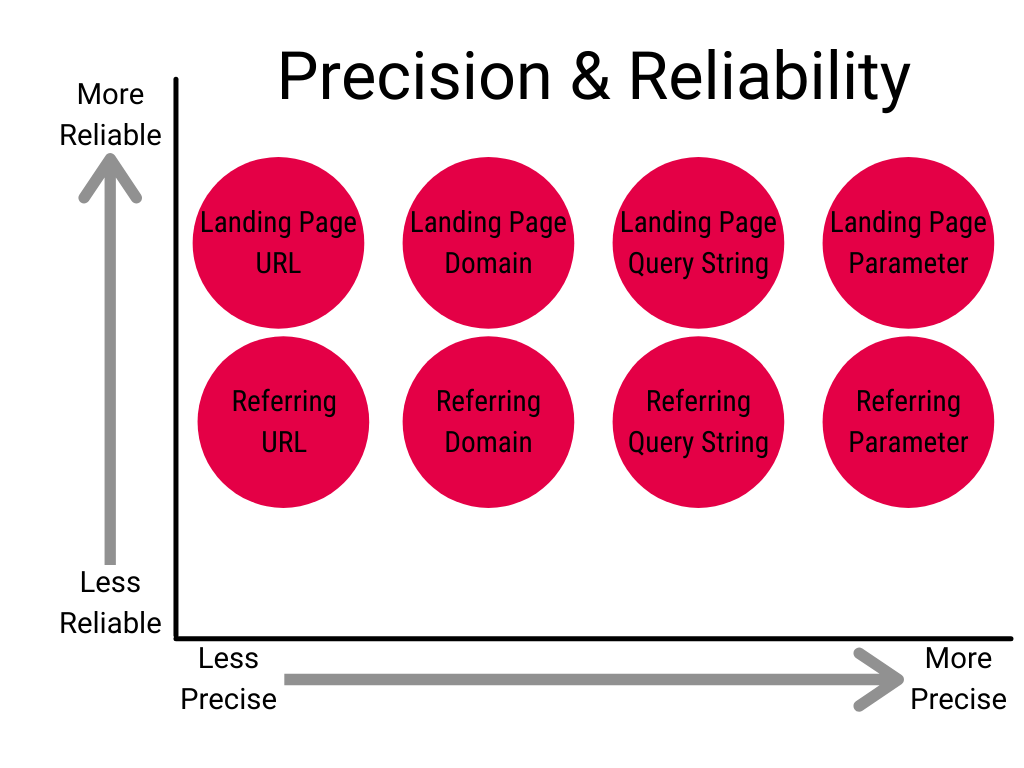
ルールターゲットは、精度と信頼性の観点で評価できます。次のチャートは、さまざまなルールターゲットをそれぞれの精度と信頼性で示しています。グラフの原点から遠いほど、ルールターゲットはより高精度(x軸)かつより高信頼(y軸)です。
常に、可能な限り信頼性と精度の高いルールターゲットを使うようにし、他に選択肢がない場合にのみグラフの左または下へ移動してください。以下に、どのルールターゲットを使うかを選ぶ2つの例を示します。
**例1:有料検索**
このシナリオでは、すべての有料検索トラフィックにGoogleのUTMパラメータ `utm_medium=search`が付与されています。そのため、 **ランディングページパラメータ** をルールターゲットにすべきです。Rules To Identifyは次のようになります:
| ルールターゲット | ルール値1 | ルールロジック | |
|---|
| ランディングページURL | utm_medium | * | * |
〜をご覧ください *ルールロジック - 例1* セクションを見て、 *ルールロジック* および *ルール値2*.
**例2:オーガニック検索**
次のチャネルであるオーガニック検索にはUTMパラメータがなく、ランディングページも予測できません。これらの条件により、パラメータとクエリ文字列を対象とするすべてのルールターゲット、およびすべてのランディングページ系ルールターゲットは除外されます。上のグラフを見ると、これらすべての要素を考慮した最適な選択肢は **参照ドメイン**です。Rules To Identifyは次のようになります:
| ルールターゲット | ルール値1 | ルールロジック | |
| -------- | ----- | ------- | -- |
| 参照ドメイン | `--` | \* | \* |
〜をご覧ください *ルールロジック - 例2* セクションを見て、 *ルールロジック* および *ルール値2*.
ルールロジックのオプションを選ぶ
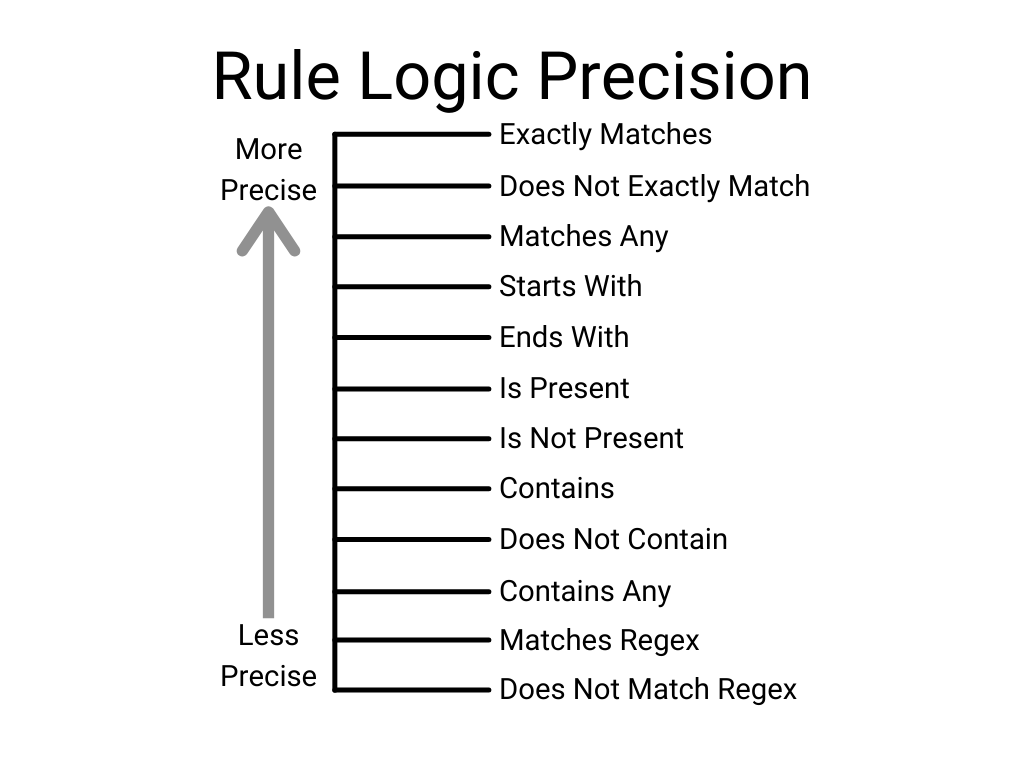
ルールロジックは、精度でのみ評価できます。次のチャートは、さまざまなルールロジックのオプションを相対的な精度で示しています。
常に、可能な限り精度の高いルールロジックのオプションを使うようにし、他に選択肢がない場合にのみグラフを下へ移動してください。以下に、どのルールロジックのオプションを使うかを選ぶ2つの例を示します。
**例1:有料検索**
すべての有料検索にはGoogleのUTMパラメータ `utm_medium=search`が付与されているため、最も適切なルールロジックのオプションは **完全一致**.
| ルールターゲット | ルール値1 | ルールロジック | |
| ------------ | ------------ | ------- | -------- |
| ランディングページURL | `utm_medium` | 完全一致 | `search` |
**完全一致** はここでは最適です。なぜなら、正確なパラメータのキーと値の組み合わせである `utm_medium=search` トラフィックだけが、このチャネルの一部と見なされるべきだからです。
たとえば、もしルールロジックのオプション **含む** を使った場合、 `utm_medium` を含む `search` 値はすべてこのチャネルの一部と見なされ、誤ったアトリビューション、補填対応、その他の問題につながる可能性があります。 **含む** ただし、ここでそれを選ぶのが間違いだというわけではありません; **完全一致** 単に、より良い選択肢というだけです。
**例2:オーガニック検索**
先に参照ドメインのルールターゲットが最良の選択であると確定しているため、考えられるルールロジックのオプションは次のとおりです:
| ルールターゲット | ルール値1 | ルールロジック | |
| -------- | ----- | ------- | ------ |
| 参照ドメイン | `--` | 含む | .bing. |
**含む** はここでは良い選択です。なぜなら、Bingのオーガニック検索は次のような複数の異なる参照URLから発生しうるためです:
* `https://cn.bing.com`
* `https://www4.bing.com/search`
* `https://www2.bing.com/search`
サードレベルドメイン(例: *www、cn*)、トップレベルドメイン(例: *com、net*)、およびURLパスがどれほど異なりうるかを考えると、参照ドメインに **.bing.** のセカンドレベルドメインが含まれていることを確認するだけで、Bingから来るすべてのオーガニック検索トラフィックをこのチャネルの一部として扱えるようになります。
こうした理由から、これ以上精度の高いルールロジックのオプションは選べません。そうしたオプションでは、このチャネルの一部として扱うべき参照ドメインが除外されてしまうからです。
**正規表現のルールロジックオプション**
正規表現ソリューションの実装は複雑であるため、impact.comではOptimizeで正規表現を実装する方法について一般的な助言や指示は提供していません。正規表現のルールロジックオプションが最適だと思われる場合は、実装を始める方法についてCSMに相談してください。
#### 完全一致 vs. いずれかに一致
この2つのルールロジックオプションはまったく同じように機能しますが、わずかな違いがあります。 *完全一致* RTIに記載されたとおりの正確なルール値2のみを検索します。 *いずれかに一致* ルールに正確に記載されたすべてのルール値2を検索します。
もし **完全一致** を **かつ** 演算子とともに複数回使っているなら、 **いずれかに一致**同様です。 **含む** および **いずれかを含む**.
#### 共通のクリックID
クリックIDは、有料メディアでますます一般的になっています。以下は、トラフィックの識別に使用できる一般的なクリックIDの一覧です。
| メディアソース | クリック ID |
| --------------------- | --------- |
| Google広告 | `GCLID` |
| Bing Ads/Yahoo Search | `MSCLKID` |
| Facebook広告 | `FBCLID` |
| Pinterest | `EPIK` |
#### トラフィックの除外
ときには、Rules To Identifyを作成して *除外する* トラフィックを識別することは、チャネルの一部としてトラフィックを特定するのと同じくらい役立つ場合があります。上の例を使って、トラフィックを除外するように設定する方法を以下の小節で見てみましょう。
{% tabs %}
{% tab title="例1:有料検索" %}
以下は、上で作成した例です:
| | | | |
| ------------ | ------------ | ----------- | --------- |
| **ルールターゲット** | **ルール値1** | **ルールロジック** | **ルール値2** |
| ランディングページURL | `utm_medium` | 完全一致 | `search` |
このルールはすでに多くのトラフィックを除外しています。さらに別のRules To Identifyを追加し、 **OR** 演算子を使用することで、より多くのトラフィックを対象にできるようになります:
| | | | |
| -------------- | ------------ | ----------- | --------- |
| **ルールターゲット** | **ルール値1** | **ルールロジック** | **ルール値2** |
| ランディングページURL | `utm_medium` | 完全一致 | `search` |
| **OR** | | | |
| ランディングページパラメータ | `GCLID` | 存在する | -- |
これで、どちらかのルールが真であれば、そのトラフィックはこのチャネルの一部として識別されます。
{% endtab %}
{% tab title="例2:オーガニック検索" %}
以下は、上で作成した例です:
| ルールターゲット | ルール値1 | ルールロジック | ルール値2 |
| -------- | ----- | ------- | ------ |
| 参照ドメイン | `--` | 含む | .bing. |
このルールはBingから参照されたすべてのトラフィックを識別します。さらに別のルールを追加し、 **かつ** 演算子を使用すると、Bingから参照されたトラフィックの除外を始められます:
| ルールターゲット | ルール値1 | ルールロジック | ルール値2 |
| -------------- | ---------- | ------- | ------ |
| 参照ドメイン | `--` | 含む | .bing. |
| **かつ** | | | |
| ランディングページパラメータ | `MSCLIKID` | 存在しない | -- |
| {% endtab %} | | | |
| {% endtabs %} | | | |
これで、トラフィックがこのチャネルの一部として識別されるには、両方のルールが真である必要があります。
#### 大文字小文字の区別
Rules To Identifyは大文字小文字を区別しません。たとえば、 `utm_medium=SEARCH`というパラメータがある場合でも、ルールを次のように設定できます:
| ルールターゲット | ルール値1 | ルールロジック | ルール値2 |
| ------------ | ------------ | ------- | -------- |
| ランディングページURL | `utm_medium` | 完全一致 | `search` |
#### 次は?
いくつかの [Optimizeの設定シナリオ](/brand/ja/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-channels/optimize-channel-setup-scenario-examples.md)を確認してください。ここでは、一般的なOptimizeシナリオに対する推奨事項を見つけられます。
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://help.impact.com/brand/ja/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-channels/channel-setup-strategy.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.