> For the complete documentation index, see [llms.txt](https://help.impact.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://help.impact.com/brand/fr/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-channels/channel-setup-strategy.md).

# Stratégie de configuration des canaux

{% hint style="warning" %}
**Important**: Familiarisez-vous avec les ressources suivantes avant de passer à cet article :

* [Guide de démarrage d'Optimize](/brand/fr/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-startup-guide.md)
* [Qu'est-ce qu'une règle pour identifier ?](/brand/fr/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/set-up-rules-to-identify-channel-traffic.md)
* [Qu'est-ce qu'un groupe de crédit ?](/brand/fr/what-would-you-like-to-learn-about/platform-features/actions-and-payouts/credit-groups-explained.md)
  {% endhint %}

Cet article couvre les fonctionnalités et les fonctions des règles pour identifier (RTI) d'Optimize. Vous apprendrez à élaborer une stratégie pour configurer les règles pour identifier (RTI) pour de nouveaux canaux ou modifier des canaux existants dans votre programme.

Il n'existe pas de solution universelle adaptée à toutes les situations. Cependant, vous devriez pouvoir parvenir à une solution qui s'adapte au mieux à votre situation particulière. Des arguments contre la configuration d'une certaine RTI peuvent toujours exister, mais **le but d'une RTI n'est pas de fonctionner dans toutes les situations**. **Une RTI est conçue pour être adaptée à vos besoins spécifiques**.

Ce document approfondira les connaissances fondamentales et fonctionnelles nécessaires pour concevoir les règles pour identifier optimales pour votre programme.

{% hint style="info" %}
**Gardez les configurations de canal ciblées**: N'oubliez pas qu'Optimize vise à mettre en évidence des informations au niveau du canal ; lorsque vous créez votre RTI, vous devez tenir compte de la manière d'identifier le trafic provenant d'un canal particulier. Garder cela à l'esprit vous aidera à garder votre RTI simple, ciblée et efficace.
{% endhint %}

**Petit rappel**

* Une cible de règle est le « où » de la règle, c'est-à-dire l'endroit où la règle cherchera à appliquer la logique de règle et à trouver la ou les valeurs de règle.
* La logique de règle est le « comment » par lequel la règle tentera d'identifier le trafic.
* Les valeurs de règle sont les données que vous fournissez à la règle pour l'aider.

#### Précision et fiabilité

Lors de la conception de votre RTI, les concepts clés à garder à l'esprit sont la précision et la fiabilité. Les choix de l'option Cible de règle et de Logique de règle dans une règle ne doivent pas être considérés comme interchangeables, même si plusieurs ensembles de composants fonctionneront dans un scénario donné. Voir les sections suivantes pour des exemples.

<details>

<summary>Choisir une cible de règle</summary>

Les cibles de règle peuvent être évaluées selon leur précision et leur fiabilité. Le graphique suivant représente les différentes cibles de règle en fonction de leur précision et fiabilité respectives. Plus une cible de règle est éloignée de l'origine du graphique, plus elle est précise (sur l'axe des x) et fiable (sur l'axe des y).
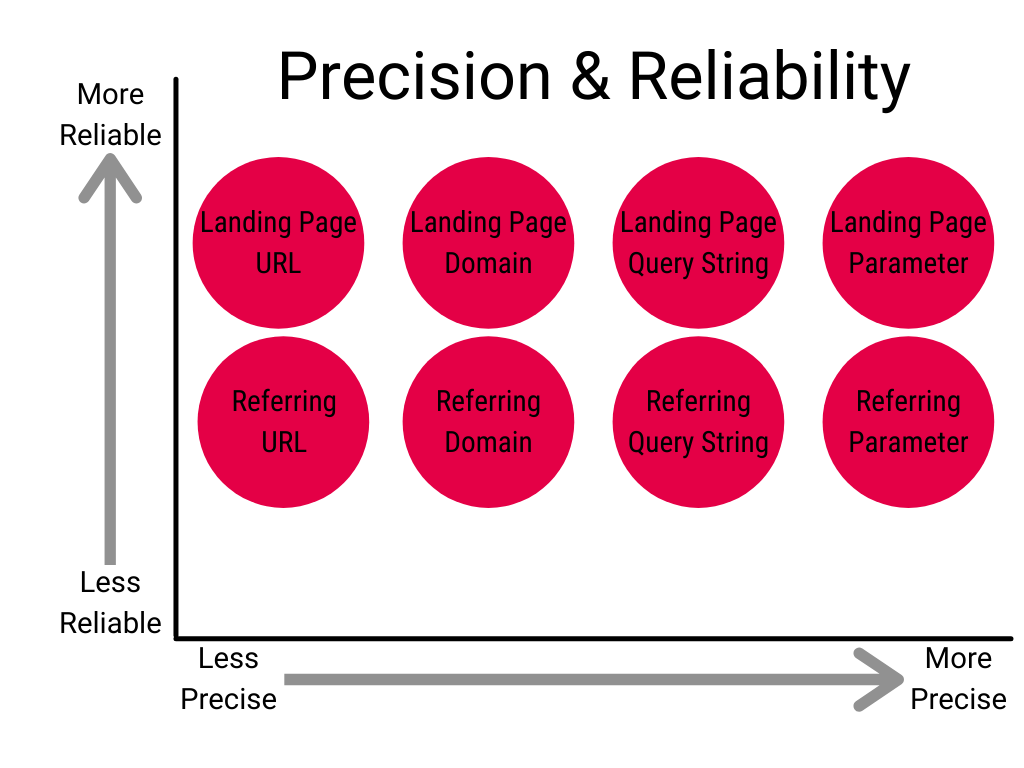
<div data-with-frame="true"><figure><img src="https://57104473-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FwMLlMoFBtKJa8ptd3zaw%2Fuploads%2Fgit-blob-489f6f57993cbcf93749f93b54b796fd3f2f0095%2Fc19fe1a665f9b3e512fe5afb73ca76dfe2ae37fcda9f0873ae316bebaf1fb02c.png?alt=media" alt=""><figcaption></figcaption></figure></div>

Vous devriez toujours essayer d'utiliser la cible de règle la plus fiable et la plus précise possible, et ne vous déplacer vers la gauche ou vers le bas du graphique que si vous n'avez pas d'autre choix. Voici deux cas d'exemple pour choisir la cible de règle à utiliser.

**Exemple 1 : Recherche payante**

Dans ce scénario, tout le trafic de recherche payante est balisé avec le paramètre UTM de Google `utm_medium=search`. De ce fait, la **Paramètre de la page de destination** doit être la cible de règle. La règle pour identifier commencera à ressembler à ceci :

<table><thead><tr><th width="128">Cible de règle</th><th>Valeur de règle 1</th><th>Logique de règle</th><th></th></tr></thead><tbody><tr><td>URL de la page de destination</td><td><code>utm_medium</code></td><td>*</td><td>*</td></tr></tbody></table>

Consultez le *Logique de règle - Exemple 1* section pour voir quoi renseigner pour la *Logique de règle* et *Valeur de règle 2*.

**Exemple 2 : Recherche organique**

Le canal suivant, la recherche organique, n'aura aucun paramètre UTM et la page d'atterrissage sera imprévisible. Ces conditions excluent toutes les cibles de règle qui visent les paramètres et les chaînes de requête, ainsi que toutes les cibles de règle de page d'atterrissage. Comme vous pouvez le voir sur le graphique ci-dessus, la meilleure option compte tenu de tous ces facteurs est alors la **Domaine de référence**. La règle pour identifier commencera à ressembler à ceci :

| Cible de règle       | Valeur de règle 1 | Logique de règle |    |
| -------------------- | ----------------- | ---------------- | -- |
| Domaine de référence | `--`              | \*               | \* |

Consultez le *Logique de règle - Exemple 2* section pour voir quoi renseigner pour la *Logique de règle* et *Valeur de règle 2*.

</details>

<details>

<summary>Choisir une option de logique de règle</summary>

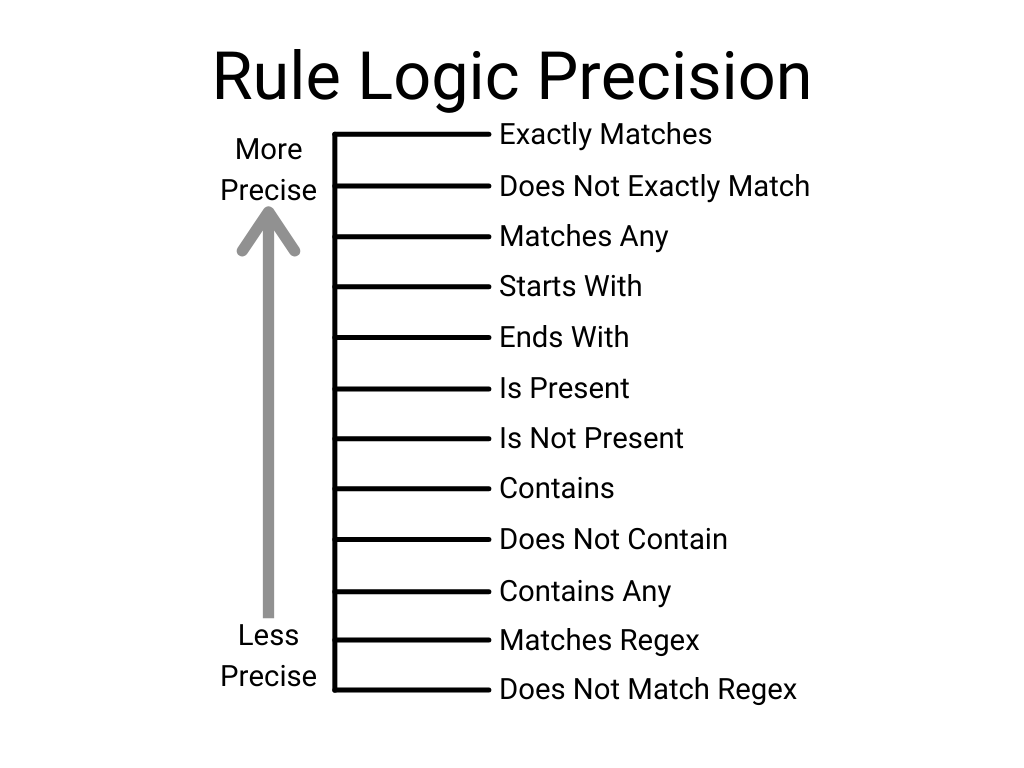
La logique de règle ne peut être évaluée que selon sa précision. Le graphique suivant représente les différentes options de logique de règle en fonction de leur précision relative.

<div data-with-frame="true"><figure><img src="https://57104473-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FwMLlMoFBtKJa8ptd3zaw%2Fuploads%2Fgit-blob-c917a70e8cfa00de3db2c1855ae9276f687da113%2F5a7fdeb96314eec55916b1fb0357483ee17dd3aec317357e20bbf514232c2ab0.png?alt=media" alt=""><figcaption></figcaption></figure></div>

Vous devriez toujours essayer d'utiliser l'option de logique de règle la plus précise possible, et ne descendre dans le graphique que si vous n'avez pas d'autre choix. Voici deux cas d'exemple pour choisir l'option de logique de règle à utiliser.

**Exemple 1 : Recherche payante**

Puisque toute la recherche payante est balisée avec le paramètre UTM de Google `utm_medium=search`, la meilleure option de logique de règle possible serait **Correspond exactement**.

| Cible de règle                | Valeur de règle 1 | Logique de règle      |          |
| ----------------------------- | ----------------- | --------------------- | -------- |
| URL de la page de destination | `utm_medium`      | Correspond exactement | `search` |

**Correspond exactement** fonctionne le mieux ici, car seul le trafic ayant la paire clé-valeur exacte du paramètre `utm_medium=search` doit être considéré comme faisant partie de ce canal.

Si, par exemple, l'option de logique de règle **Contient** était utilisée à la place, toute `utm_medium` valeur contenant `search` serait considérée comme faisant partie de ce canal, ce qui peut entraîner des actions mal attribuées, des compensations, et potentiellement davantage. **Contient** ne serait cependant pas un mauvais choix ici ; **Correspond exactement** elle se trouve simplement être le meilleur choix.

**Exemple 2 : Recherche organique**

La cible de règle Domaine référent ayant été établie comme le meilleur choix plus tôt, une option potentielle de logique de règle pourrait être la suivante :

| Cible de règle       | Valeur de règle 1 | Logique de règle |        |
| -------------------- | ----------------- | ---------------- | ------ |
| Domaine de référence | `--`              | Contient         | .bing. |

**Contient** est un bon choix ici, car la recherche organique de Bing peut provenir de plusieurs URL référentes différentes, telles que :

* `https://cn.bing.com`
* `https://www4.bing.com/search`
* `https://www2.bing.com/search`

En raison des différences entre les domaines de troisième niveau (par ex., *www, cn*), les domaines de premier niveau (par ex., *com, net*), et les chemins d'URL, il suffit de s'assurer que le domaine référent contient le domaine de second niveau de **.bing.** pour permettre à tout le trafic de recherche organique provenant de Bing d'être considéré comme faisant partie de ce canal.

</details>

C'est également pour ces raisons qu'aucune option de logique de règle plus précise ne peut être choisie, car elle exclurait des domaines référents qui devraient être considérés comme faisant partie de ce canal.

**Options de logique de règle Regex**

En raison de la complexité de mise en œuvre des solutions regex, impact.com ne fournit pas de conseils généraux ni de directives sur la manière d'implémenter des expressions régulières dans Optimize. Si vous pensez que votre situation se prête le mieux à une option de logique de règle regex, consultez votre CSM pour savoir comment commencer à la mettre en œuvre.

#### Correspond exactement vs. Correspond à n'importe lequel

Ces deux options de logique de règle fonctionnent exactement de la même manière, mais avec une légère distinction. *Correspond exactement* ne recherchera que la valeur de règle 2 exacte telle qu'elle est écrite dans la RTI. *Correspond à n'importe lequel* recherchera toutes les valeurs de règle 2 telles qu'elles sont exactement écrites dans la règle.

Si vous vous retrouvez à utiliser **Correspond exactement** plus d'une fois avec l' **ET** opérateur, envisagez d'utiliser **Correspond à n'importe lequel**. Il en va de même pour **Contient** et **Contient n'importe lequel**.

#### IDs de clic courants

Les IDs de clic deviennent de plus en plus courants dans les médias payants. Voici une liste d'IDs de clic courants que vous pouvez utiliser pour identifier le trafic.

| Source média          | ID du clic |
| --------------------- | ---------- |
| Google Ads            | `GCLID`    |
| Bing Ads/Yahoo Search | `MSCLKID`  |
| Facebook Ads          | `FBCLID`   |
| Pinterest             | `EPIK`     |

#### Trafic disqualifié

Parfois, créer des règles pour identifier qui *disqualifient* le trafic peut être tout aussi utile pour identifier le trafic comme faisant partie d'un canal. Consultez les sous-sections ci-dessous pour voir comment les exemples créés ci-dessus peuvent être configurés pour disqualifier le trafic.

{% tabs %}
{% tab title="Exemple 1 : Recherche payante" %}
Voici l'exemple créé ci-dessus :

|                               |                       |                       |                       |
| ----------------------------- | --------------------- | --------------------- | --------------------- |
| **Cible de règle**            | **Valeur de règle 1** | **Logique de règle**  | **Valeur de règle 2** |
| URL de la page de destination | `utm_medium`          | Correspond exactement | `search`              |

Cette règle disqualifie déjà beaucoup de trafic. En ajoutant une autre règle pour identifier et en utilisant l' **OU** opérateur, la règle peut être élargie pour qualifier davantage de trafic :

|                                     |                       |                       |                       |
| ----------------------------------- | --------------------- | --------------------- | --------------------- |
| **Cible de règle**                  | **Valeur de règle 1** | **Logique de règle**  | **Valeur de règle 2** |
| URL de la page de destination       | `utm_medium`          | Correspond exactement | `search`              |
| **OU**                              |                       |                       |                       |
| Paramètre de la page de destination | `GCLID`               | Est présent           | --                    |

Désormais, si l'une ou l'autre des règles est vraie, le trafic sera identifié comme faisant partie de ce canal.
{% endtab %}

{% tab title="Exemple 2 : Recherche organique" %}
Voici l'exemple créé ci-dessus :

| Cible de règle       | Valeur de règle 1 | Logique de règle | Valeur de règle 2 |
| -------------------- | ----------------- | ---------------- | ----------------- |
| Domaine de référence | `--`              | Contient         | .bing.            |

Cette règle identifiera tout le trafic référé par Bing. En ajoutant une autre règle et en utilisant l' **ET** opérateur, la règle peut commencer à disqualifier le trafic référé par Bing :

| Cible de règle                      | Valeur de règle 1 | Logique de règle  | Valeur de règle 2 |
| ----------------------------------- | ----------------- | ----------------- | ----------------- |
| Domaine de référence                | `--`              | Contient          | .bing.            |
| **ET**                              |                   |                   |                   |
| Paramètre de la page de destination | `MSCLIKID`        | N'est pas présent | --                |
| {% endtab %}                        |                   |                   |                   |
| {% endtabs %}                       |                   |                   |                   |

Désormais, les deux règles doivent être vraies pour que le trafic soit identifié comme faisant partie de ce canal.

#### Sensibilité à la casse

Les règles pour identifier ne sont pas sensibles à la casse. Par exemple, si vous avez un paramètre où `utm_medium=SEARCH`, vous pouvez tout de même configurer votre règle comme suit :

| Cible de règle                | Valeur de règle 1 | Logique de règle      | Valeur de règle 2 |
| ----------------------------- | ----------------- | --------------------- | ----------------- |
| URL de la page de destination | `utm_medium`      | Correspond exactement | `search`          |

#### Quelle est la suite ?

Consultez quelques [scénarios de configuration d'Optimize](/brand/fr/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-channels/optimize-channel-setup-scenario-examples.md). Vous y trouverez des recommandations pour des scénarios courants d'Optimize.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://help.impact.com/brand/fr/what-would-you-like-to-learn-about/platform-features/cross-channel-performance-insights/optimize-channels/channel-setup-strategy.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.